
第二步:建模分析
配置已完成,现在是见证奇迹的时刻——建模!
🤖 平台怎么选算法
平台会根据你的数据配置自动推荐算法,你也可以在数据配置中手动指定:
| 你的配置 | 自动选择 | 说明 |
|---|---|---|
| 只有 X 列 | PCA | 探索模式:看看数据长什么样、有没有聚类 |
| 有 X 和 Y,Y 是连续数值 | PLS | 预测模式:建立 X 和 Y 之间的回归关系 |
| 有 X 和 Y,Y 是类别标签 | PLS-DA | 判别模式:判断样本属于哪一类 |
手动可选的全部五种模型:
PCA · PLS · PLS-DA · OPLS · OPLS-DA
💡 什么时候考虑 OPLS / OPLS-DA? 当数据存在明显的系统性噪声(基线漂移、环境漂移、批次系统偏差), 或者你希望得分图更"干净"、更容易向他人解释时。它们会先剥离与 Y 无关的正交变异,再建模。
⚠️ 注意:OPLS 家族的"组件数"指的是被剥离的正交成分数,不是潜变量数(预测成分固定为 1 个)。 详见 核心模型算法详解。
⚡ 点击 Fit,开始训练
点击 Fit(重新拟合)按钮,平台会通过交叉验证自动寻找最佳组件数。
训练过程中会显示进度,完成后模型进入"已拟合"状态。
💡 自动搜索的行为可以调整:交叉验证折数、最大组件数上限、早停容忍度等七个参数,都在 设置 → 模型训练设置 里配置。详见 模型训练设置。
🎛️ 调参数就像调音量
模型好不好,参数很重要。最关键的参数是 组件数 (Components),也叫"潜变量"。
- C+1 / C-1 按钮:
- 点击 C+1,增加一个组件,模型变得更复杂,拟合更好,但可能过拟合。
- 点击 C-1,减少一个组件,模型更简单,泛化能力更强。
⚠️ 各模型的"组件数"含义并不相同:
模型 C+1 增加的是 PCA 主成分个数 PLS / PLS-DA 潜变量(Latent Variable)个数 OPLS / OPLS-DA 正交成分(被剥离的噪声层)个数
📊 看懂体检报告
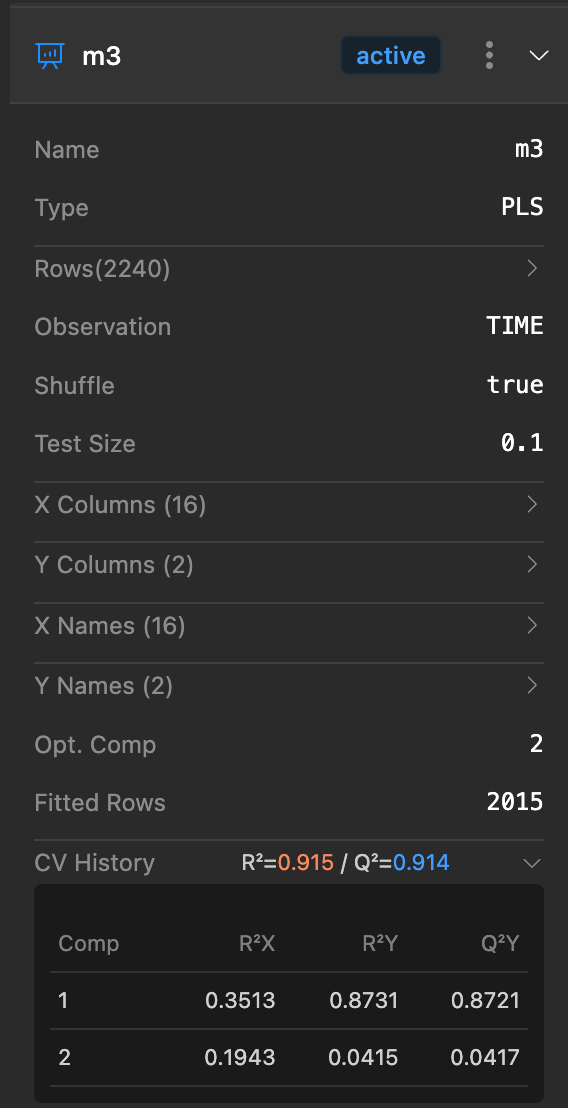
每次模型更新(如删除异常数据、调整组件数 C+1/C-1)后,系统会自动重新计算。你只需要点击展开模型详情,就能看到最新的"体检 报告":
回归类模型(PLS / OPLS):
- R2X (自变量解释率):模型解释了多少 X 数据(特征)的信息。
- R2Y (因变量解释率):模型解释了多少 Y 数据(结果)的信息。越高越好,比如 0.9 就很棒!
- Q2Y (预测能力):最关键指标!代表模型对未知数据的预测准不准。如果 R2Y 很高但 Q2Y 很低,那是"死记硬背"(过拟合), 得减组件。
- RMSE (误差):越低越好,代表预测值和真实值的平均差距。
分类类模型(PLS-DA / OPLS-DA):
- Accuracy(准确率):预测正确的比例。
- F1 Score:精确率与召回率的调和平均,类别不平衡时比准确率更可靠。
- AUC:ROC 曲线下面积,衡量模型的整体区分能力(0.5 为随机,1.0 为完美)。
💡 各指标的通俗解释与常见误区,详见 关键术语解答。
🎯 建完模先别急着下结论
模型跑出来只是起点。接下来通常会做两件事:
当然,也可以直接让 AI 帮你诊断: